August 19, 2024
Datenvirtualisierung einfach erklärt
Viele Unternehmen sind sich des Werts ihrer Daten bewusst. Die grössere Herausforderung besteht darin, diesen Wert tatsächlich nutzbar zu machen. Geschäftsdaten verteilen sich heute über ERP-, CRM-, PIM-, MDM- und weitere operative Systeme, Data Warehouses und Data Lakes sowie Cloud-Plattformen und externe Datenquellen. Um diese Daten gemeinsam für Analytics, operative Prozesse oder KI-Anwendungen nutzen zu können, braucht es einen konsistenten und möglichst einfachen Zugang.
Viele Unternehmen sind sich des Werts ihrer Daten bewusst. Die grössere Herausforderung besteht darin, diesen Wert tatsächlich nutzbar zu machen. Geschäftsdaten verteilen sich heute über ERP-, CRM-, PIM-, MDM- und weitere operative Systeme, Data Warehouses und Data Lakes sowie Cloud-Plattformen und externe Datenquellen. Um diese Daten gemeinsam für Analytics, operative Prozesse oder KI-Anwendungen nutzen zu können, braucht es einen konsistenten und möglichst einfachen Zugang.
Diese Anforderung ist nicht neu. Bereits seit Jahrzehnten werden Daten aus unterschiedlichen Quellen integriert und für Anwender zentral verfügbar gemacht. Mit hybriden Cloud-Landschaften, steigenden Datenmengen, Echtzeitanforderungen und KI haben sich die Anforderungen an die Datenintegration jedoch deutlich verändert.
Datenvirtualisierung bietet hierfür einen logischen Ansatz: Statt Daten für jeden Anwendungsfall zunächst physisch an einem neuen Ort zusammenzuführen, schafft sie eine virtuelle Zugriffsschicht über unterschiedliche Datenquellen. In diesem Blogartikel erklären wir, was Datenvirtualisierung ist, wie sie sich von klassischer Datenintegration unterscheidet und welche Rolle sie in modernen Datenarchitekturen wie Data Fabric und Data Mesh spielt.
Was ist Datenvirtualisierung?
Datenvirtualisierung ist eine Technologie zur logischen Datenintegration. Sie ermöglicht es, Daten aus unterschiedlichen Quellen über eine gemeinsame Zugriffsschicht bereitzustellen, ohne dass diese dafür zwingend physisch in einem zentralen System gespeichert werden müssen. Die Daten verbleiben grundsätzlich in ihren Quellsystemen. Die Virtualisierungsschicht abstrahiert deren technische Unterschiede und stellt Anwendern, Applikationen oder Analysewerkzeugen eine einheitliche Sicht auf die benötigten Daten zur Verfügung.
Dadurch können beispielsweise Daten aus ERP, CRM, PIM, Data Warehouse, Data Lake oder Cloud-Anwendungen gemeinsam abgefragt werden, obwohl sie physisch weiterhin in unterschiedlichen Systemen liegen. Datenvirtualisierung ersetzt klassische Datenintegration dabei nicht vollständig. Vielmehr ergänzt sie ETL/ELT, APIs, Streaming und andere Integrationsmethoden um einen logischen Zugriff auf verteilte Daten.
Physische und virtuelle Datenintegration: Wo liegt der Unterschied?
Als Datenintegration wird der Prozess bezeichnet, bei dem Daten aus unterschiedlichen Quellen so miteinander verbunden werden, dass sie gemeinsam genutzt werden können. Grundsätzlich lässt sich zwischen physischer und virtueller beziehungsweise logischer Datenintegration unterscheiden.
Bei der physischen Datenintegration werden Daten tatsächlich zwischen Systemen bewegt oder repliziert. Beim klassischen ETL-Verfahren – Extract, Transform, Load – werden sie beispielsweise aus verschiedenen Quellsystemen extrahiert, transformiert und anschliessend in ein Zielsystem wie ein Data Warehouse geladen. Moderne Architekturen verwenden daneben beispielsweise ELT, Change Data Capture oder Streaming, um Daten effizienter beziehungsweise nahezu in Echtzeit zwischen Systemen zu übertragen.
Der Vorteil physischer Integration besteht darin, dass Daten gezielt für bestimmte Analyse- und Verarbeitungszwecke vorbereitet und performant in einem Zielsystem bereitgestellt werden können. Gleichzeitig entstehen zusätzliche Datenkopien, Pipelines und Transformationsprozesse, die betrieben und aktuell gehalten werden müssen.
Bei der virtuellen Datenintegration verbleiben die Daten dagegen grundsätzlich in ihren jeweiligen Quellsystemen. Eine logische Abstraktionsschicht verbindet die Quellen und stellt die benötigten Daten bei einer Abfrage in einer einheitlichen Sicht zur Verfügung. Das reduziert die Notwendigkeit, Daten für jeden neuen Anwendungsfall zunächst zu replizieren. Gleichzeitig werden Datenkonsumenten von der technischen Komplexität der darunterliegenden Systeme entkoppelt.
Physische Datenintegration
- Prinzip: Daten werden bewegt oder repliziert
- Typische Technologien: ETL, ELT, CDC, Streaming
- Speicherung: Zusätzliche physische Datenhaltung
- Aktualität: Abhängig von Pipeline und Synchronisation
- Performance: Für definierte Workloads optimierbar
- Flexibilität: Änderungen können Anpassungen an Pipelines erfordern
- Geeignet für: Persistente Analytics-Daten, historische Analysen, hohe Workloads
Virtuelle Datenintegration
- Prinzip: Daten werden logisch zusammengeführt
- Typische Technologien: Datenvirtualisierung, Federation
- Speicherung: Daten verbleiben grundsätzlich in den Quellen
- Aktualität: Abfrage aktueller Quelldaten möglich
- Performance: Abhängig von Quellen, Netzwerk und Query-Optimierung
- Flexibilität: Neue Quellen und Views lassen sich häufig schneller integrieren
- Geeignet für: Verteilte Daten, schnelle Bereitstellung, operative und aktuelle Datensichten
In der Praxis lautet die Entscheidung selten ETL oder Datenvirtualisierung. Moderne Datenarchitekturen kombinieren physische und logische Integrationsmethoden abhängig vom jeweiligen Use Case.
Wie funktioniert Datenvirtualisierung?
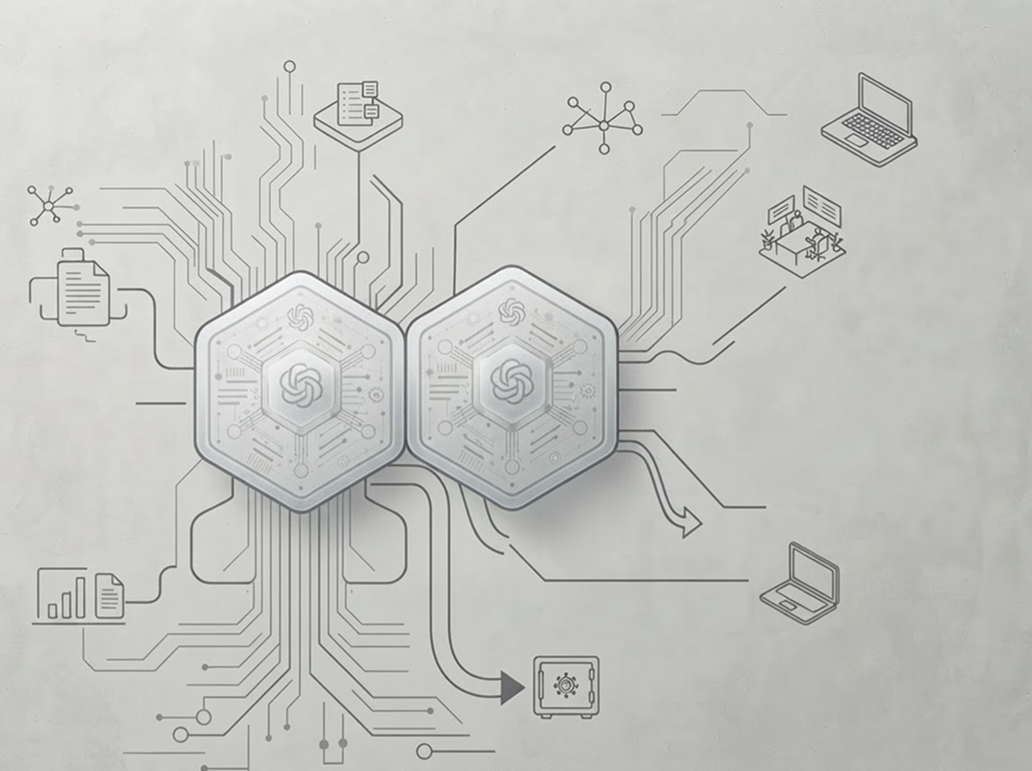
Zwischen Datenquellen und Datenkonsumenten wird eine logische Datenebene geschaffen. Diese verbindet sich mit den verschiedenen Quellsystemen und abstrahiert deren technische Strukturen.
Stellt ein Anwender oder eine Applikation eine Anfrage, übersetzt die Virtualisierungsschicht diese in entsprechende Abfragen der beteiligten Quellsysteme. Die Ergebnisse werden anschliessend zusammengeführt und in der benötigten Form bereitgestellt. Für den Datenkonsumenten entsteht dadurch eine einheitliche Sicht, obwohl die zugrunde liegenden Informationen weiterhin aus mehreren physischen Quellen stammen.
Moderne Datenvirtualisierungsplattformen können darüber hinaus semantische Modelle, Metadaten, Zugriffsrechte, Sicherheitsrichtlinien und Governance-Regeln zentral verwalten. Damit wird die logische Datenebene nicht nur zur technischen Integrationsschicht, sondern auch zu einer Möglichkeit, Daten konsistent und kontrolliert bereitzustellen.
Welche Rolle spielt Datenvirtualisierung in Data Fabric und Data Mesh?
Datenvirtualisierung wird häufig im Zusammenhang mit Data Fabric und Data Mesh genannt. Die drei Begriffe beschreiben jedoch unterschiedliche Dinge:
Data Fabric
Eine Data Fabric ist ein Architekturansatz, der den Zugriff auf Daten über unterschiedliche Systeme, Clouds und organisatorische Bereiche hinweg vereinfachen soll. Dafür kombiniert sie verschiedene Technologien und Methoden – beispielsweise Metadatenmanagement, Datenintegration, Data Governance, Automatisierung und Datenvirtualisierung. Datenvirtualisierung kann somit ein wichtiger Bestandteil einer Data Fabric sein, ist aber nicht mit ihr gleichzusetzen.
Über eine logische Zugriffsschicht können Daten aus unterschiedlichen Systemen verfügbar gemacht werden, ohne sie für jeden Anwendungsfall zunächst zentral replizieren zu müssen. Andere Daten werden dagegen weiterhin über ETL/ELT, Streaming oder andere Integrationsmethoden bereitgestellt.
Data Mesh
Data Mesh beschreibt dagegen primär ein organisatorisches und architektonisches Prinzip. Datenverantwortung wird stärker auf einzelne Geschäftsdomänen verteilt. Fachbereiche übernehmen Ownership für bestimmte Daten und stellen sie anderen Bereichen als sogenannte Data Products zur Verfügung. Anstatt sämtliche Verantwortung bei einem zentralen Data Team zu bündeln, sollen diejenigen Bereiche Daten verantworten, die deren fachlichen Kontext am besten kennen.
Datenvirtualisierung kann ein Data Mesh technisch unterstützen, indem sie den domänenübergreifenden Zugriff auf verteilte Daten erleichtert. Sie ist jedoch keine Voraussetzung für ein Data Mesh. Auch APIs, Data Platforms und andere Integrationsmechanismen können Data Products bereitstellen.
Data Fabric und Data Mesh schliessen sich ebenfalls nicht gegenseitig aus. Eine Data Fabric kann beispielsweise technische Fähigkeiten bereitstellen, mit denen die in einem Data Mesh dezentral verantworteten Datenprodukte auffindbar, zugänglich und unter gemeinsamen Governance-Regeln nutzbar werden.
Welche Vorteile bietet Datenvirtualisierung?
Gerade in heterogenen und hybriden Datenlandschaften kann Datenvirtualisierung erhebliche Vorteile für Business und IT bieten.
- Schnellerer Datenzugriff. Daten müssen nicht für jeden neuen Use Case zunächst in eine zusätzliche Datenplattform kopiert und dort aufbereitet werden. Neue integrierte Datensichten können dadurch häufig schneller bereitgestellt werden.
- Weniger unnötige Datenreplikation. Da Daten grundsätzlich in ihren Quellsystemen verbleiben können, lassen sich zusätzliche Kopien und damit verbundener Speicher- und Verwaltungsaufwand reduzieren.
- Mehr Agilität. Die logische Abstraktionsschicht entkoppelt Datenkonsumenten stärker von den physischen Datenquellen. Veränderungen an der Systemlandschaft können dadurch einfacher abgefangen werden – vorausgesetzt, die logischen Datenmodelle und Schnittstellen werden entsprechend gepflegt.
- Aktuellere Datensichten. Datenvirtualisierung kann direkt auf aktuelle Quelldaten zugreifen. Damit eignet sie sich insbesondere für Use Cases, bei denen aktuelle Informationen aus mehreren operativen Systemen benötigt werden.
- Einheitlicher Datenzugriff und Governance. Eine zentrale logische Datenebene kann dabei helfen, Zugriffsrechte, Sicherheitsregeln und semantische Definitionen konsistenter über unterschiedliche Datenquellen hinweg umzusetzen.
- Bessere Grundlage für Analytics und KI. Analytics- und KI-Anwendungen benötigen Zugriff auf relevante und kontextualisierte Unternehmensdaten. Datenvirtualisierung kann dazu beitragen, verteilte Daten schneller für solche Anwendungen zugänglich zu machen, ohne für jeden Use Case zunächst eine neue physische Datenpipeline aufzubauen.
Wo liegen die Grenzen der Datenvirtualisierung?
Datenvirtualisierung ist kein Ersatz für jede Form der Datenintegration. Werden sehr grosse Datenmengen wiederholt für komplexe analytische Workloads verarbeitet, kann eine physische Materialisierung in einem Data Warehouse oder Lakehouse effizienter sein. Auch die Performance der Quellsysteme, Netzwerklatenzen und komplexe Abfragen können die Geschwindigkeit virtueller Datenzugriffe beeinflussen.
Gleichzeitig löst eine Virtualisierungsschicht keine grundlegenden Probleme der Datenqualität. Sind Produkt-, Kunden- oder Lieferantendaten in den Quellsystemen falsch, redundant oder inkonsistent, werden diese Probleme durch einen virtuellen Zugriff nicht automatisch behoben.
Datenvirtualisierung muss deshalb Teil einer umfassenderen Datenstrategie sein, die Datenintegration, Data Governance, Datenqualität, Metadatenmanagement und – wo erforderlich – Master Data Management miteinander verbindet.
Datenvirtualisierung als Baustein für AI Readiness
Mit der zunehmenden Nutzung von generativer und agentischer KI gewinnt diese Frage zusätzlich an Bedeutung. Unternehmens-KI benötigt nicht zwangsläufig sämtliche Daten in einem einzigen zentralen Speicher. Entscheidend ist vielmehr, dass relevante Daten zuverlässig, aktuell, kontextualisiert und unter klaren Zugriffsregeln verfügbar sind.
Eine logische Datenebene kann beispielsweise KI-Anwendungen oder Agenten einen kontrollierten Zugriff auf Informationen aus verschiedenen Unternehmenssystemen ermöglichen. Statt für jeden KI-Use-Case neue Datenkopien und individuelle Integrationen aufzubauen, können bestehende Datenquellen über definierte Datenservices bereitgestellt werden.
Fazit: Die richtige Datenintegration hängt vom Use Case ab
Datenvirtualisierung schafft eine logische Zugriffsschicht auf verteilte Unternehmensdaten und kann damit die Komplexität moderner Datenlandschaften erheblich reduzieren. Ihr grösster Vorteil liegt nicht darin, klassische Datenintegration vollständig zu ersetzen, sondern eine zusätzliche Möglichkeit bereitzustellen, Daten flexibel und möglichst ohne unnötige Replikation nutzbar zu machen.
In modernen Datenarchitekturen geht es darum, für jeden Use Case die richtige Kombination aus ETL/ELT, APIs, Streaming, Datenvirtualisierung und anderen Integrationsmethoden zu finden, um Antwortzeiten, Performance, Flexibilität und Datenspeicher zu optimieren.
Genau hier kommt die Erfahrung unserer Expertinnen und Experten ins Spiel: Sie betrachten Datenarchitektur nicht isoliert von den Systemen und Geschäftsprozessen, die Daten erzeugen und nutzen. Von Integration und Data Governance über MDM und Datenqualität bis hin zu Analytics und AI Enablement entwickeln sie Datenarchitekturen, die Daten dort verfügbar machen, wo sie tatsächlich Geschäftswert schaffen.
Häufige Fragen zur Datenvirtualisierung
Was versteht man unter Datenvirtualisierung?
Datenvirtualisierung ist eine Methode der logischen Datenintegration. Eine virtuelle Zugriffsschicht verbindet unterschiedliche Datenquellen und stellt deren Daten in einer einheitlichen Sicht zur Verfügung, ohne dass sämtliche Daten dafür zunächst physisch in ein zentrales System kopiert werden müssen.
Was ist der Unterschied zwischen ETL und Datenvirtualisierung?
Bei ETL werden Daten aus Quellsystemen extrahiert, transformiert und in ein Zielsystem geladen. Bei der Datenvirtualisierung verbleiben sie grundsätzlich in ihren Quellsystemen und werden über eine logische Ebene abgefragt und zusammengeführt. Beide Ansätze können innerhalb derselben Datenarchitektur eingesetzt werden.
Werden bei der Datenvirtualisierung Daten kopiert?
Grundsätzlich ermöglicht Datenvirtualisierung den Zugriff auf Daten ohne vorherige physische Replikation. Moderne Plattformen können jedoch zusätzlich mit Caching, Materialisierung oder anderen Integrationsverfahren arbeiten, wenn dies beispielsweise aus Performance-Gründen sinnvoll ist.
Was ist der Unterschied zwischen Data Fabric und Datenvirtualisierung?
Eine Data Fabric ist ein umfassender Architekturansatz für die organisationsweite Bereitstellung und Verwaltung von Daten. Datenvirtualisierung ist eine Technologie, die innerhalb einer Data Fabric eingesetzt werden kann, um verteilte Daten über eine gemeinsame logische Ebene verfügbar zu machen.
Welche Rolle spielt Datenvirtualisierung für KI?
Datenvirtualisierung kann KI-Anwendungen einen einheitlichen und kontrollierten Zugriff auf aktuelle Daten aus unterschiedlichen Unternehmenssystemen ermöglichen. Sie kann damit ein Baustein einer AI-ready Datenarchitektur sein, ersetzt aber keine Datenqualität, Governance oder semantische Aufbereitung.
Strategic Advisory & Effective Execution
We continuously innovate to transform data into competitive advantage via expert advisory, effective project execution, and precision engineering.

Unser Blog für Expert:innen.
Wir nutzen unsere Expertise in verschiedenen Disziplinen, um Daten in nachhaltige Wettbewerbsvorteile unsere Kunden zu verwandeln und unser Wissen zu teilen.

Weitere News
Alle Neugikeiten zu und über Advellence